使用说明与算法白皮书
系统怎么用 · 每个数字怎么算出来 · 出问题怎么办
与代码同源:本页所有常量取自实际实现,若与产品表现不符即为缺陷,请反馈。2026-09 版:监测看板、引用画像、行动核验、语言规则、Starter / Growth / Scale 套餐。
《AI 可见度测量标准》v1.1 →每个指标的定义、样本量、置信标注、引用覆盖(4/5 引擎)、站点比对、行动核验与公开信源清单规则,全部写在公开标准里。套餐之间只差范围,不差口径。渠道伙伴交付手册 →P1 测评 ⇄ P2 实操修改的完整交付方法论:五个标准工作包、90 天路线图与可复制模板库 · 中/英/越/泰/阿五语快速上手
工作台 → 所属组织点「+ New project」:一个项目 = 一个品牌 × 一个市场(如 某品牌 × Vietnam)。品牌有多条产品线时每条线建一个项目并排对比——不同产品线的竞对集和分数完全独立,合并测会互相掩盖。
进入工作区先跑 品牌画像(Profile):抓取官网生成一份公开事实库(定义 / 服务 / 差异化 / 量化事实 / NAP)。右栏「品牌资料」可上传品牌指南或定位文档(.txt / .md / 文本型 .pdf)。之后所有内容型智能体只引用这份事实库里的数字,库里没有的数字一律留空位。
完整扫描 串行执行 发现 → 监测 → 报告,约 4–6 分钟,任务在服务器运行,可离开页面。首次扫描自动成为 Day-0 基线;之后定期扫描按套餐节奏自动进行。
监测结果从上到下:出现率走势 → 品牌可见度 → 声量份额 → 各引擎出现率 → AI 引用的来源与引用画像 → 各问题出现率。每个格子都能点开看那条 AI 原答与引用。
按缺口依次跑 内容 / 主页 / 分发 / 百科,产出即成品交付物;发布后在右栏「记录一个行动」登记 URL,平台自动抓取核验,并在后续扫描里按问题、按引擎归因。
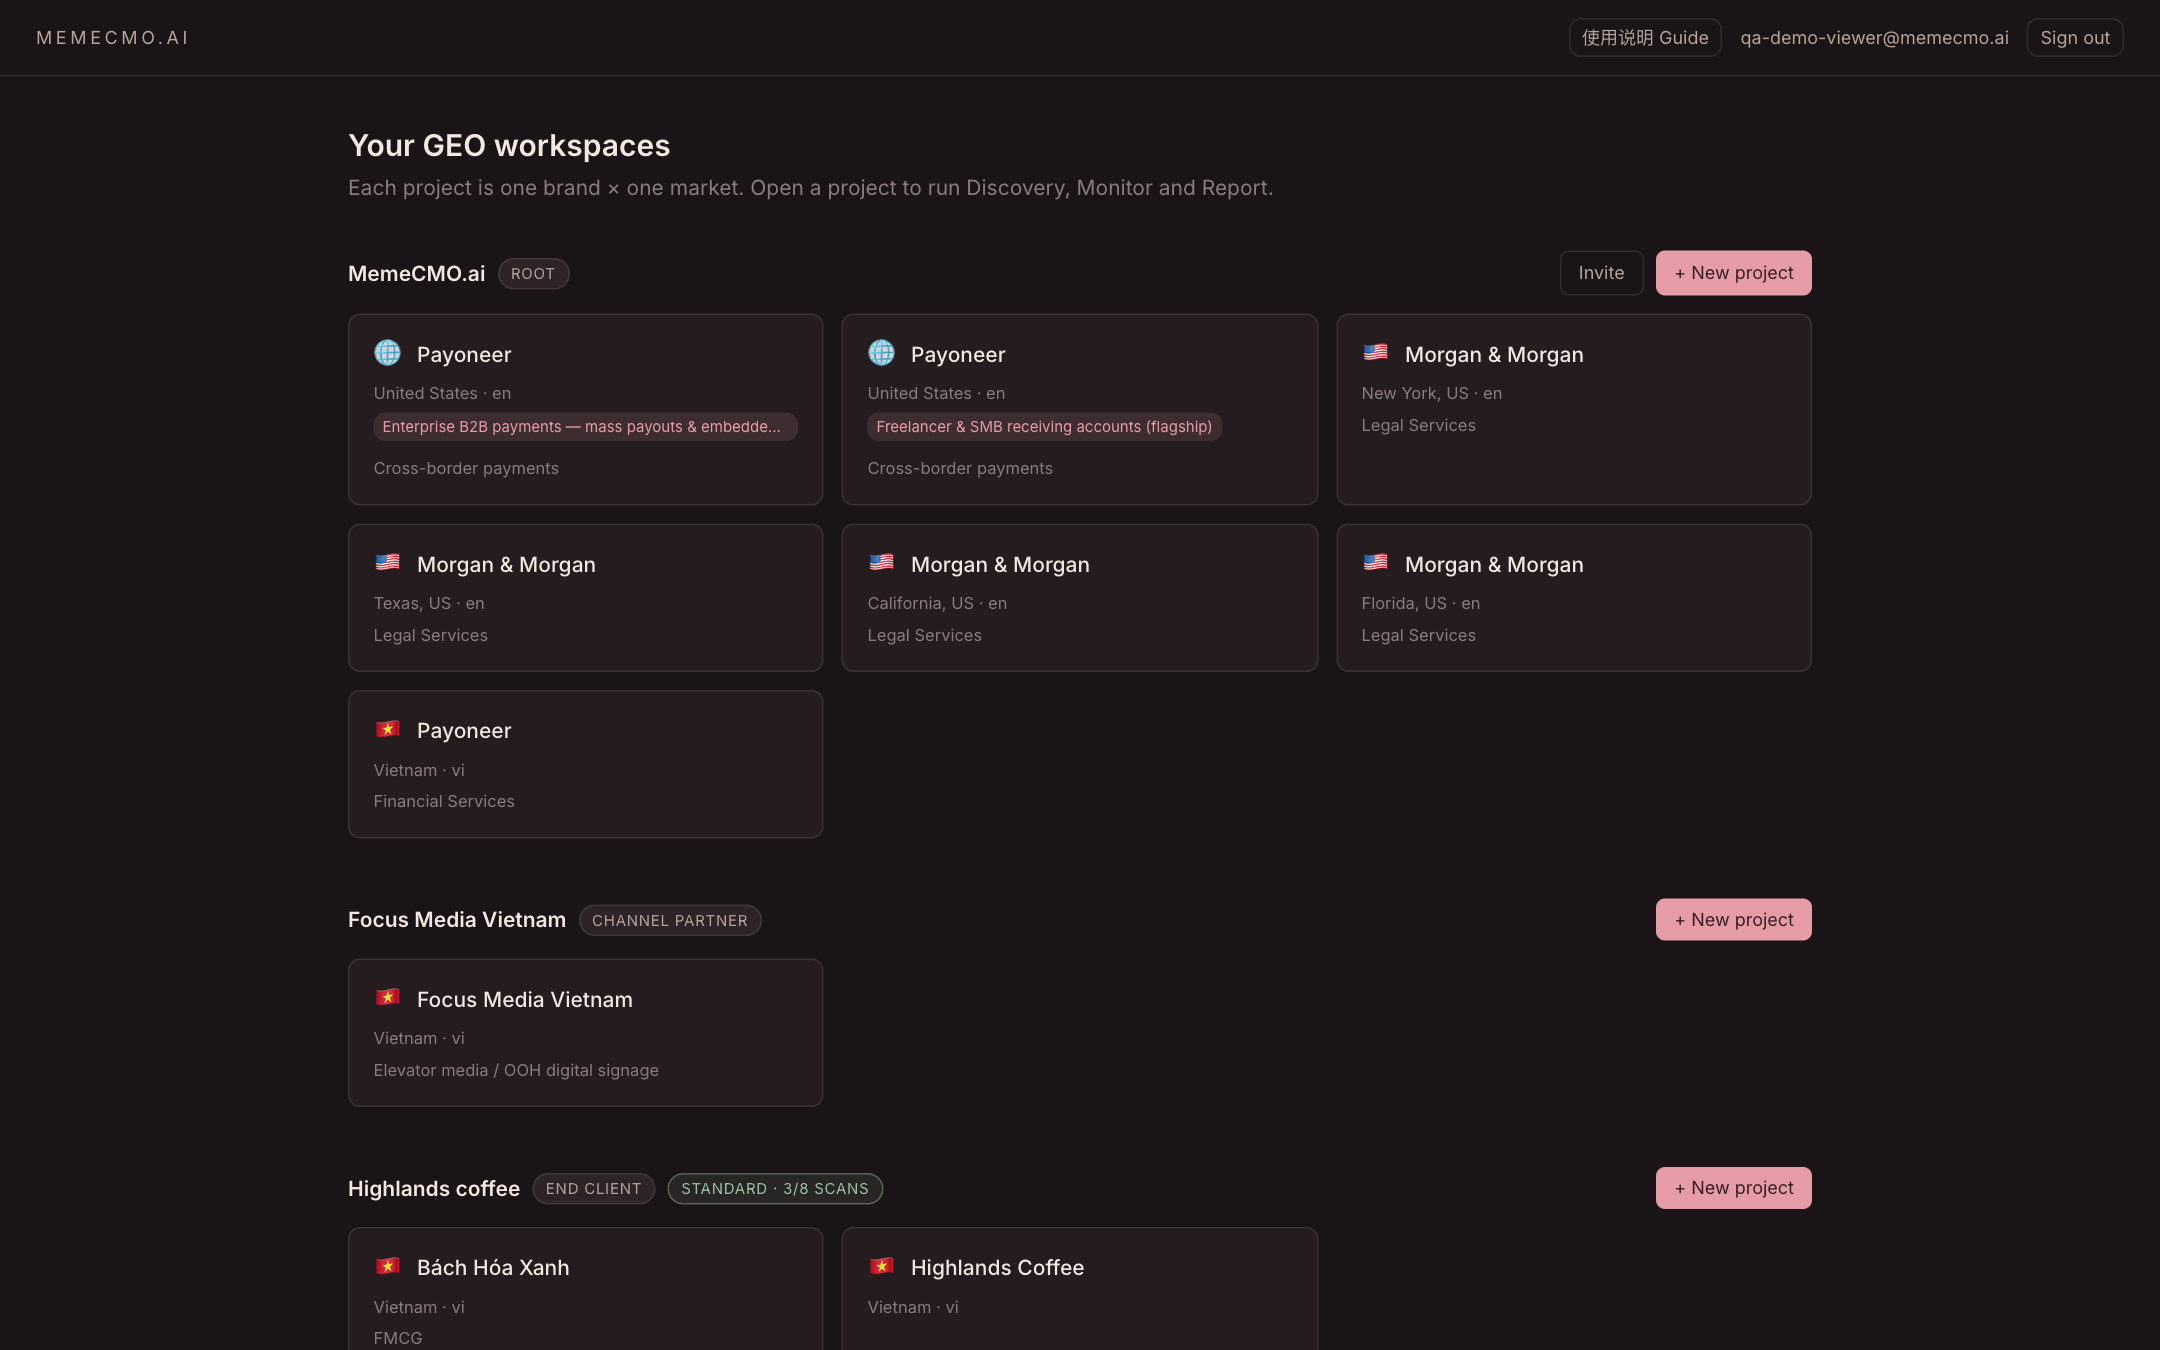
工作台与工作区布局
按组织分带:每个组织一行标题(套餐、状态、Invite、套餐与账单、+ New project / + New client),下面是项目卡片——指数圆井、出现率轨道、最近扫描时间,按最近活动排序。
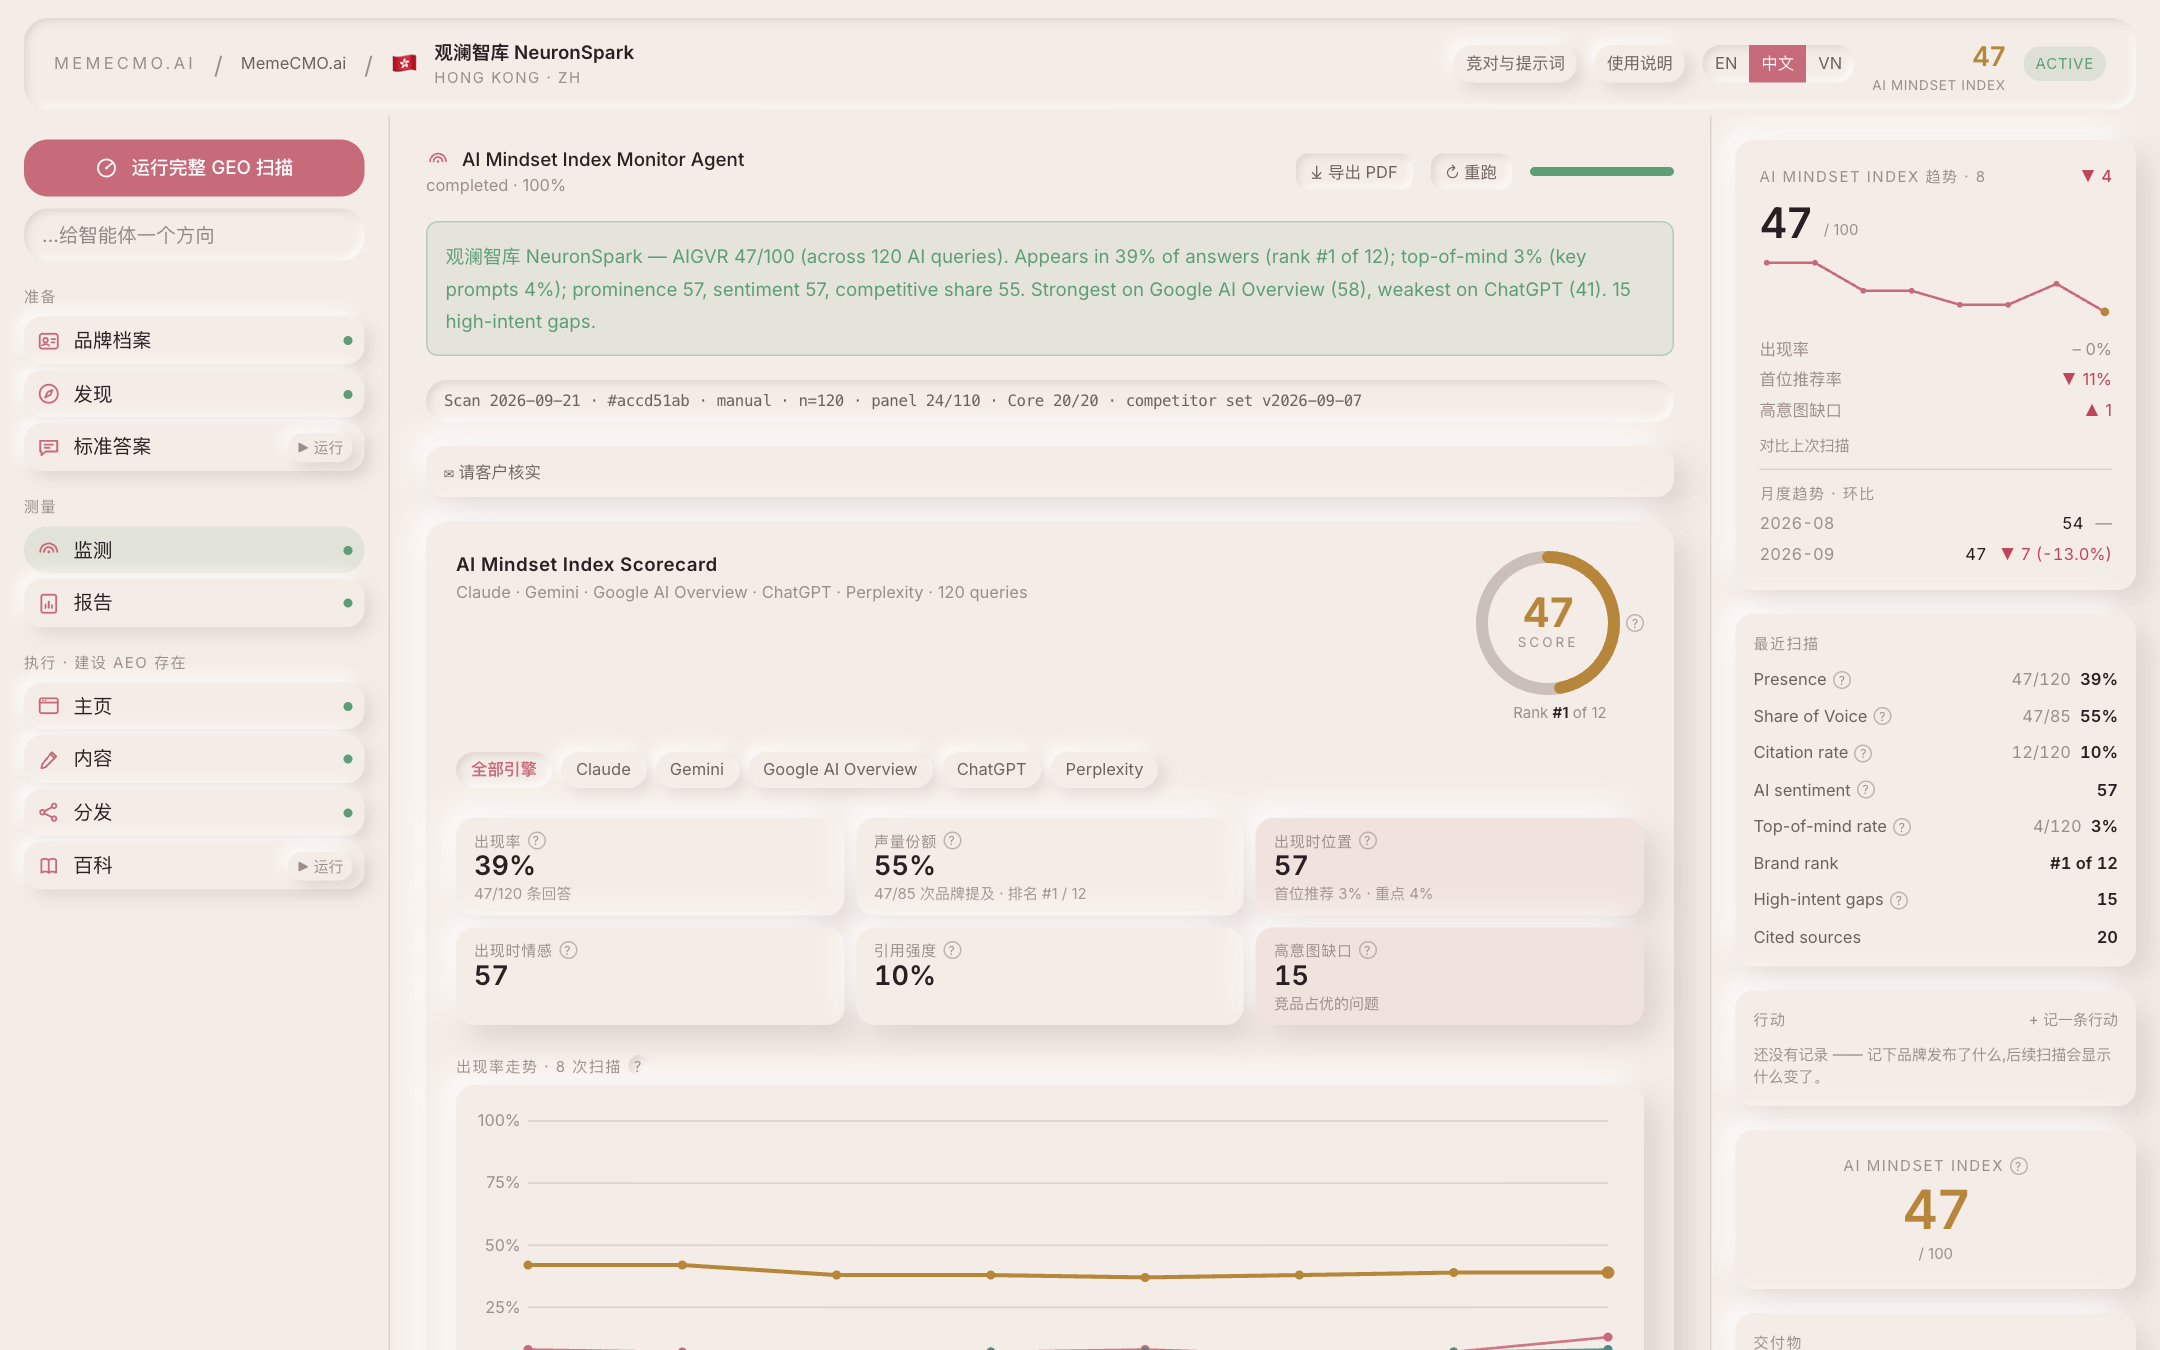
按 准备(Setup)/ 测量(Measure)/ 执行(Act)分组的 10 个智能体;每项显示最近一次运行状态,点行查看,点「运行」重跑。底部输入框可给完整扫描下达聚焦指令(如「聚焦 F&B 客户」),会改变发现阶段的出题方向。手机与平板上这一栏变为顶部横向标签。
当前选中交付物的完整结果;运行中显示分阶段进度与技术轨迹,完成后收敛为结果模块。报告与长结果默认收起,逐条展开。
最近扫描(出现率 / 声量份额 / 品牌排名 / 高意图缺口)、AIGVR 趋势与月度环比、Credit 余额、品牌资料、行动记录、就绪清单。
竞对与提示词 · 导出 PDF · 重跑 · 阅读语言(原文 / 中文 / EN)· 界面语言(中 / EN / VN)· 日 / 夜主题 · 使用说明 · 返回工作台。
智能体参考(10 个)
| 智能体 | 做什么 | 前置 | 时长 |
|---|---|---|---|
| Profile 品牌画像 | 品牌画像:抓官网 → 公开事实库(定义 / 服务 / 差异化 / 量化事实 / NAP)+ 你上传的品牌资料,全体执行智能体共用;数字只能来自这里 | — | 约 45s |
| Discovery 发现 | 发现:生成 110 条(买家旅程 5 阶段 × 22)买家会问 AI 的问题 + 标记 20 条重点;题库上限随套餐(60 / 110 / 150);支持意图聚焦 | — | 约 60s |
| Answers 标准答案 | 标准答案库:对 20 条重点各写一条「希望 AI 给出的答案」,市场语言 + 英文双语(英语市场单语),严格锚定品牌事实 | Discovery | 约 60s |
| Monitor 监测 | 监测:抽样查询 5 引擎(Starter 4 引擎),评委模型逐条打分,产出五维指数 + 竞品基准 + 缺口 + 引用;所有引用链接落库并排队抓取页面 | Discovery | 约 2–4 分钟 |
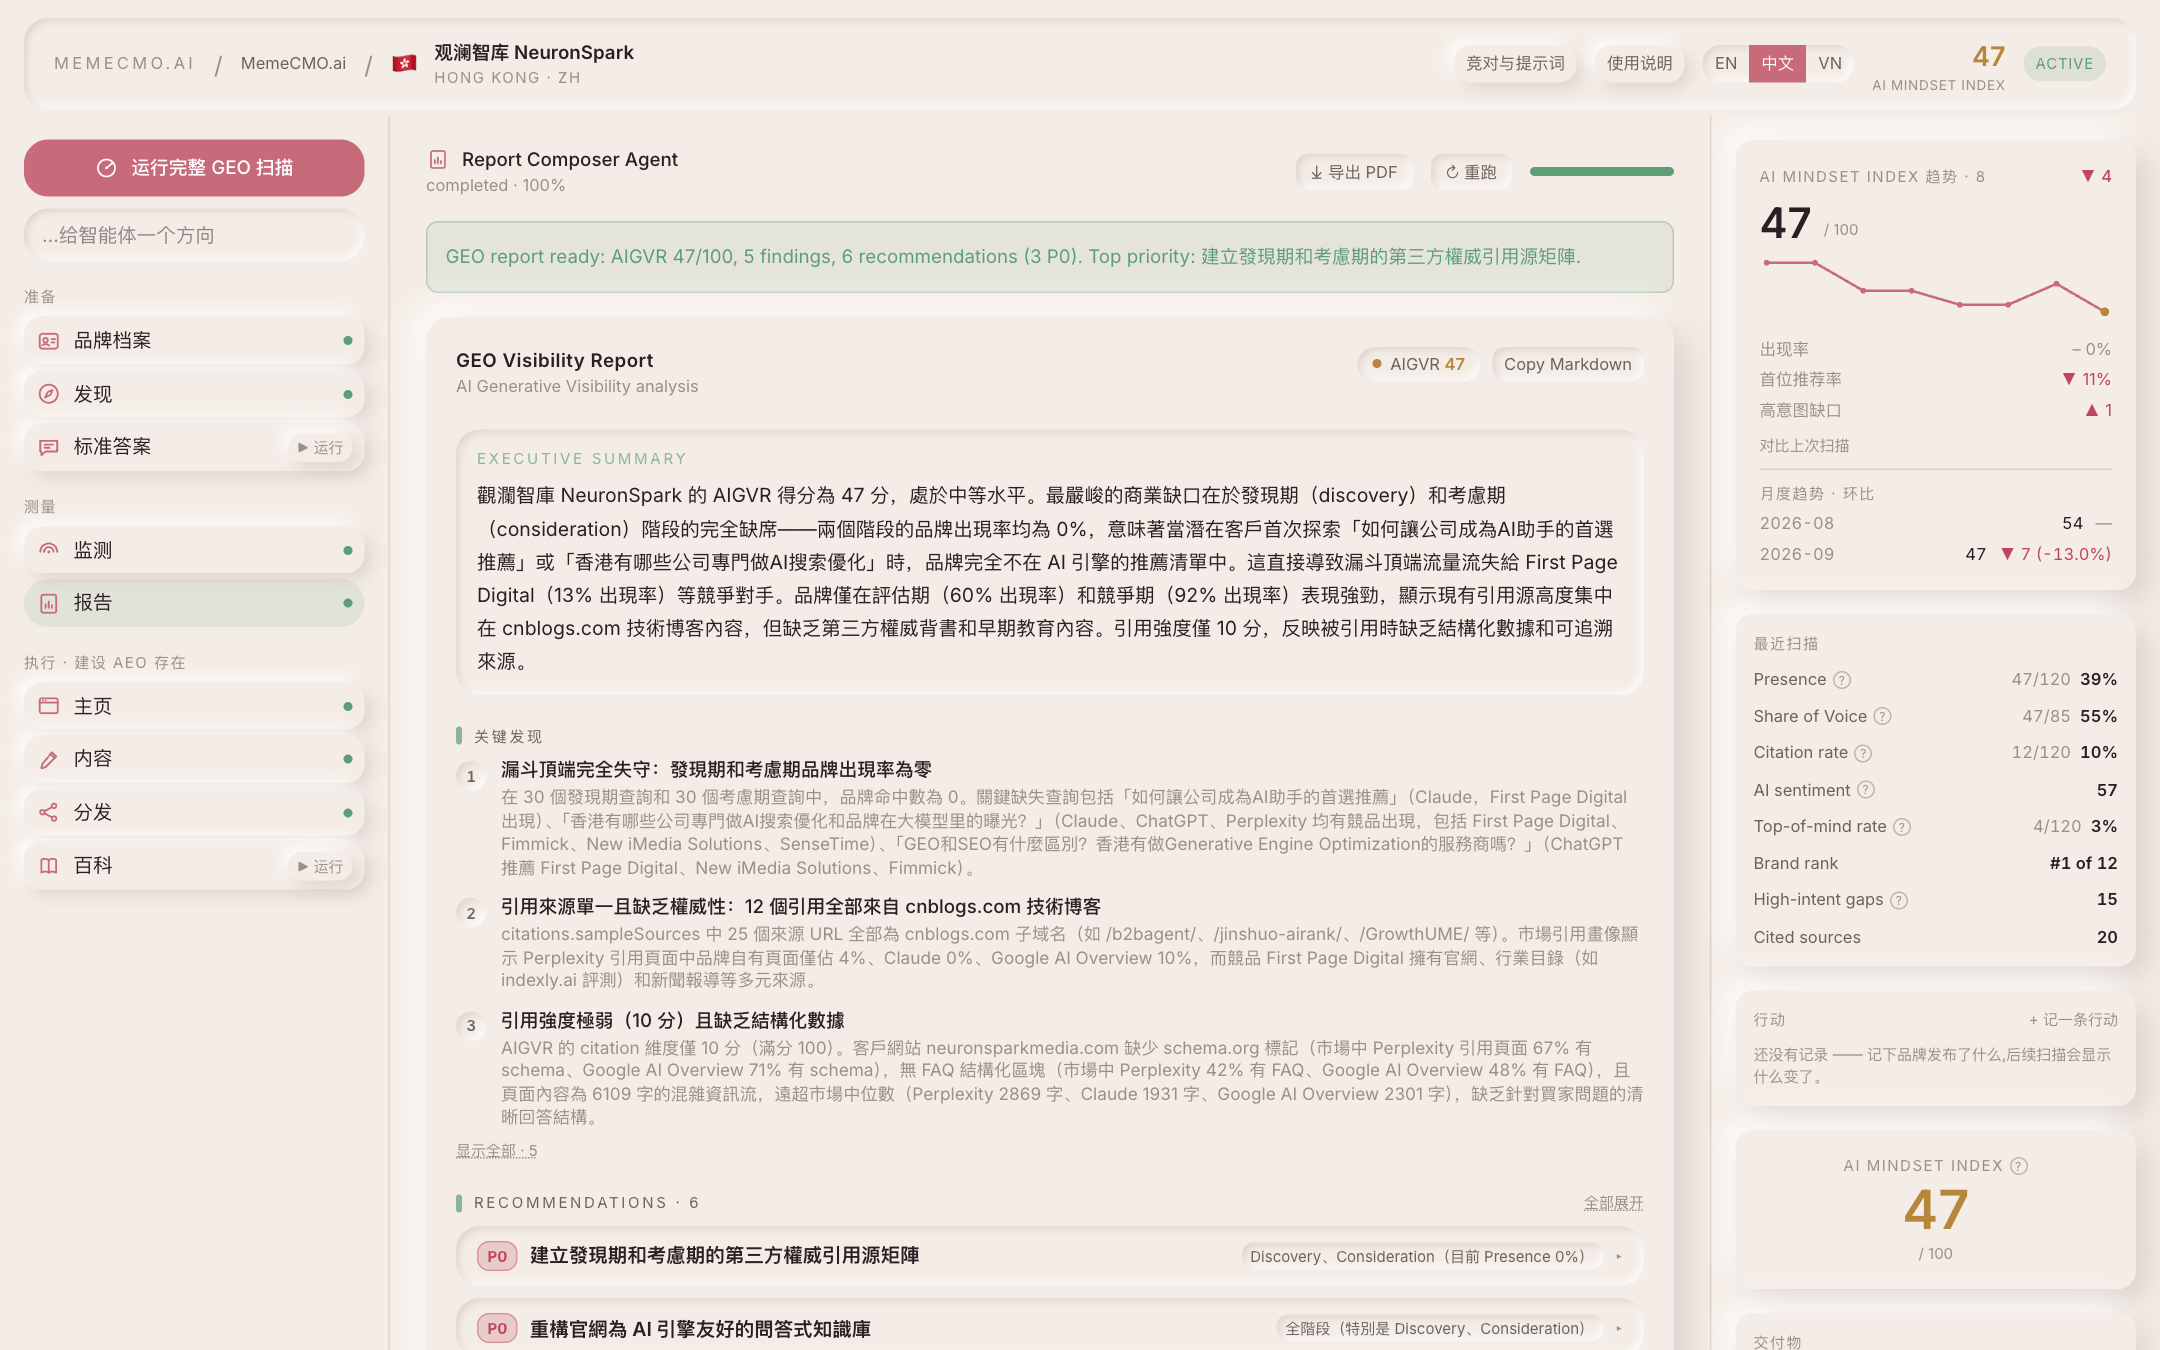
| Report 报告 | 报告:把最新评分卡写成高管可读的发现 + 建议,用市场的报告语言;附站点覆盖与「与站点矛盾的回答」 | Monitor | 约 90–150s |
| Optimize 内容 | 内容:把最大缺口写成发布级目标语言页面 + FAQ + FAQPage JSON-LD,按你市场的引用画像定结构与长度 | Monitor | 约 60s |
| Site 主页 | 主页:抓你的真实主页,产出可直接粘贴的 schema.org JSON-LD + 具体修改清单 | — | 约 60s |
| Distribute 分发 | 分发:按引用排行的高权威域名逐个生成投递稿(目录 / PR / 评测),分 3 档优先级;竞对及其供应商域名自动排除;社区渠道只出「互动简报」 | Monitor | 约 60s |
| Encyclopedia 百科 | 百科:诚实评估维基收录资格(notability),给出草稿或先建声量的现实路径;固定附合规提交路径,绝不直接发布 | — | 约 60s |
| Full Scan 完整扫描 | 完整扫描:发现 → 监测 → 报告 一键串行,断点续跑 | — | 约 4–6 分钟 |
监测看板怎么读
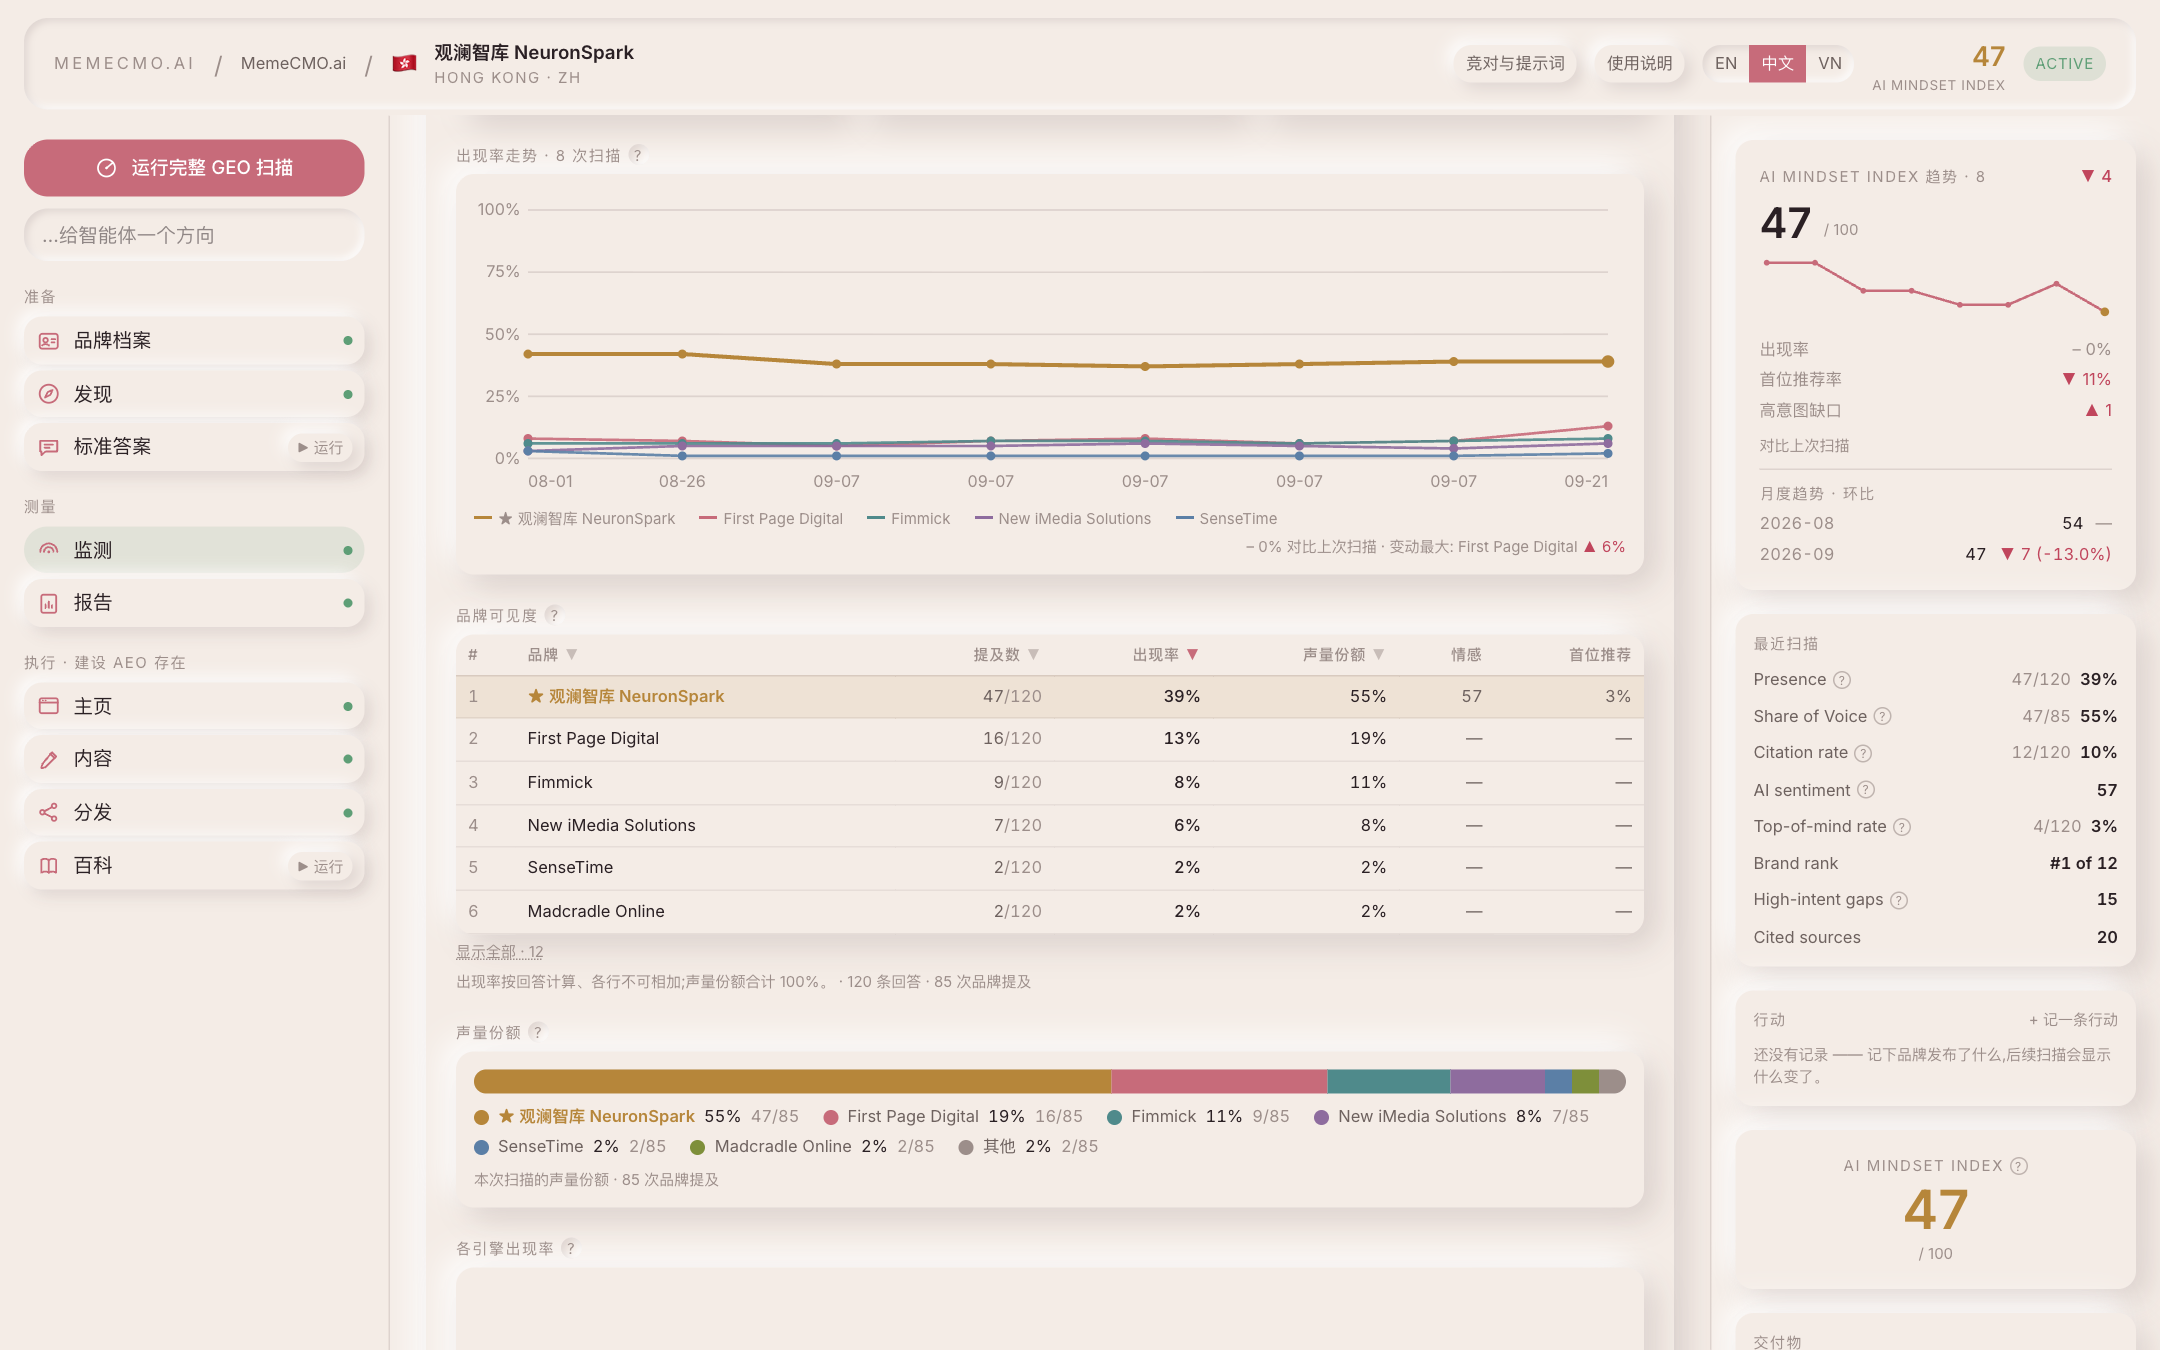
每次扫描一个点,本品牌永远金色,每个竞品有自己固定的颜色。切到某个引擎时只显示本品牌那条线(竞品线保持全量扫描口径)。图下标出「变动最大」的品牌。
每行 = 提到该品牌的回答 ÷ 全部回答。一条回答可以同时提到几个品牌,所以各行不可相加;这张表回答「出现在多少回答里」。附提及数与出现时情感。
品牌提及次数 ÷ 所有被追踪品牌的提及次数,合计 100%,回答「被提到的份额有多大」。只有关系标为「竞对」的实体进分母。
同一品牌在 5 个引擎上的出现率并排(分母是该引擎的回答数),因为同一品牌在不同引擎间差异很大。点引擎名切换整个看板到该引擎视图。
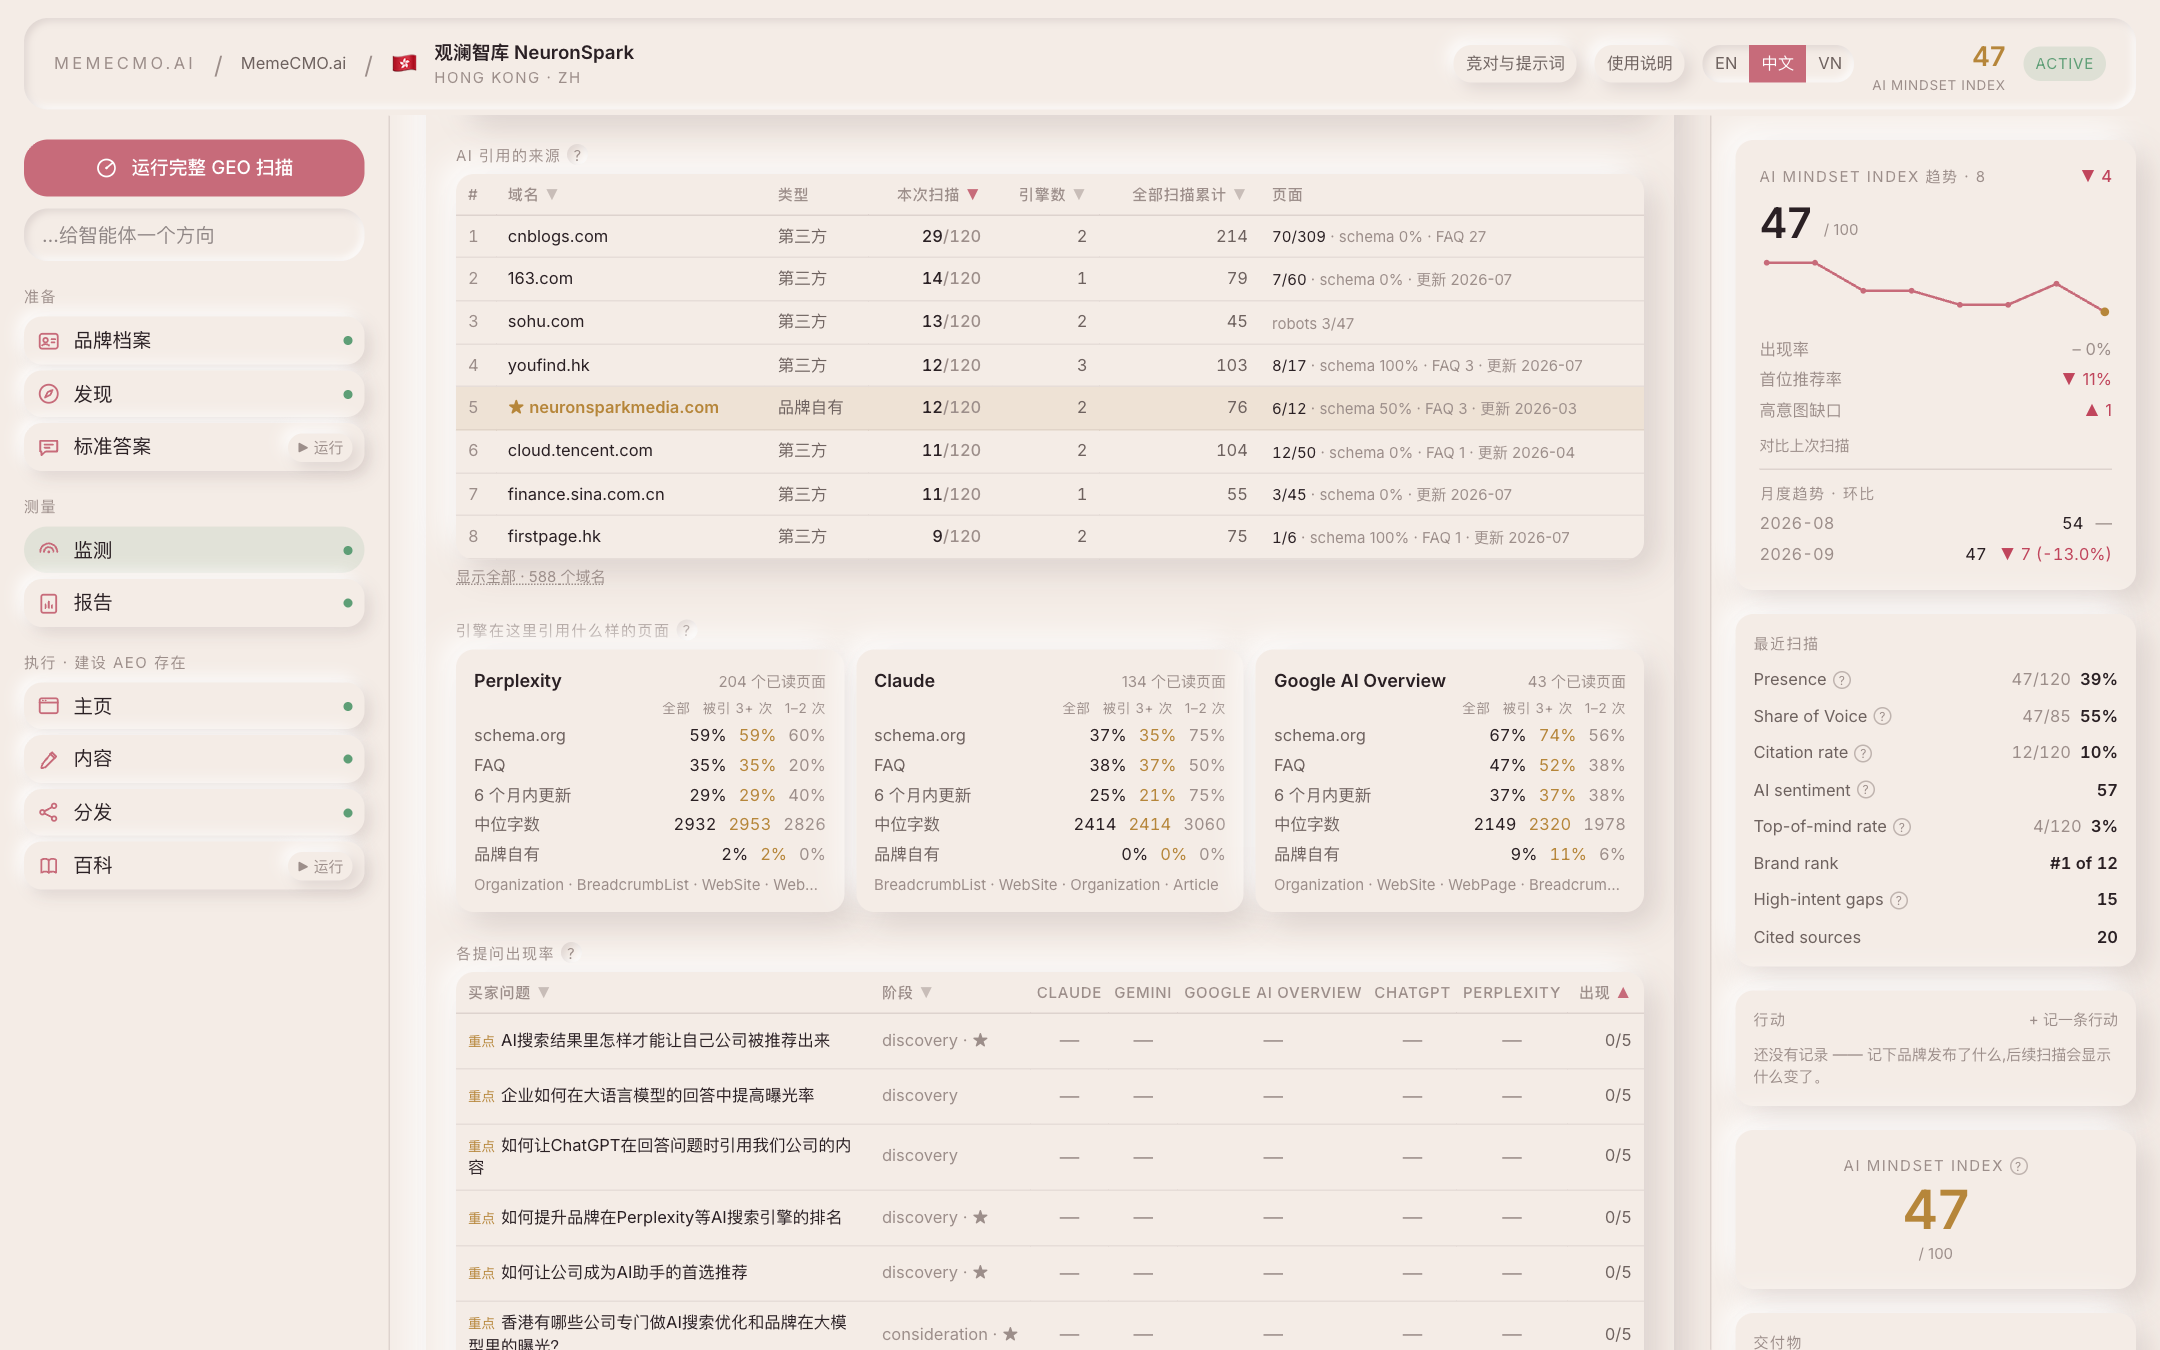
域名 × 引用次数 × 引擎数 × 已读页面。「页面」列显示我们已抓取的被引页面数(robots 拒绝会标出),悬停看词数、更新日期、schema。排行来自跨扫描的 SQL 聚合,不受 1000 行上限影响。
每个引擎至少 8 个被引页面后生成:典型结构、长度、更新频率、schema 类型。内容与主页智能体据此定稿,而不是凭经验猜。
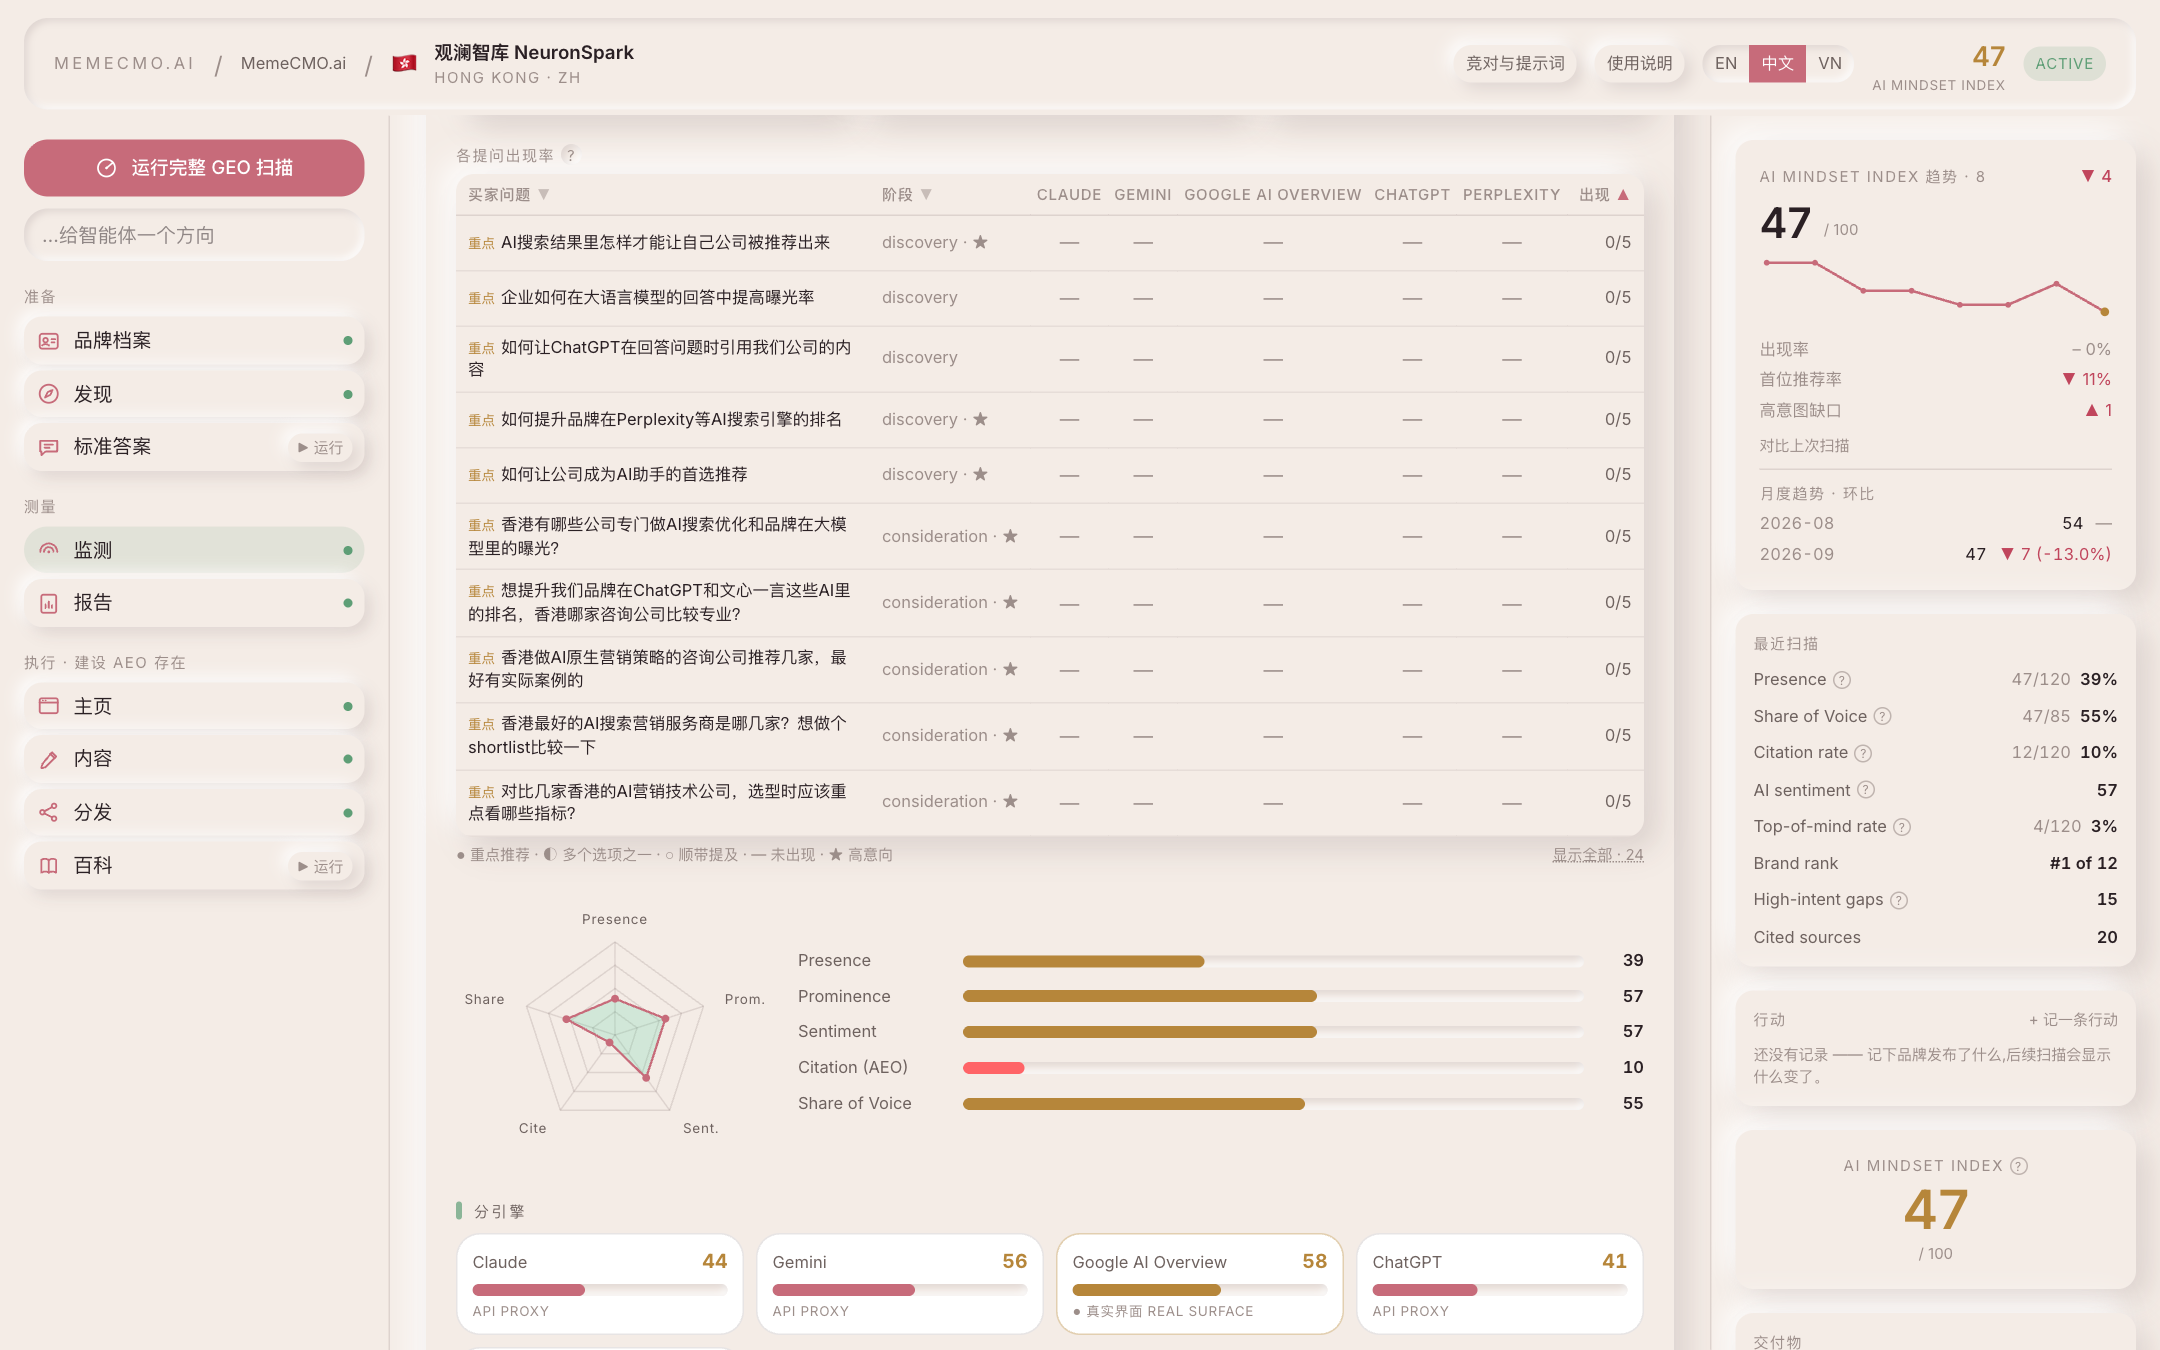
提示词 × 引擎的格子:✓ 提到、· 未提、空 = 本次未抽到。点格子打开那条 AI 原答(含引用链接);表头「显示全部」看完整题库。
竞对集与提示词库管理
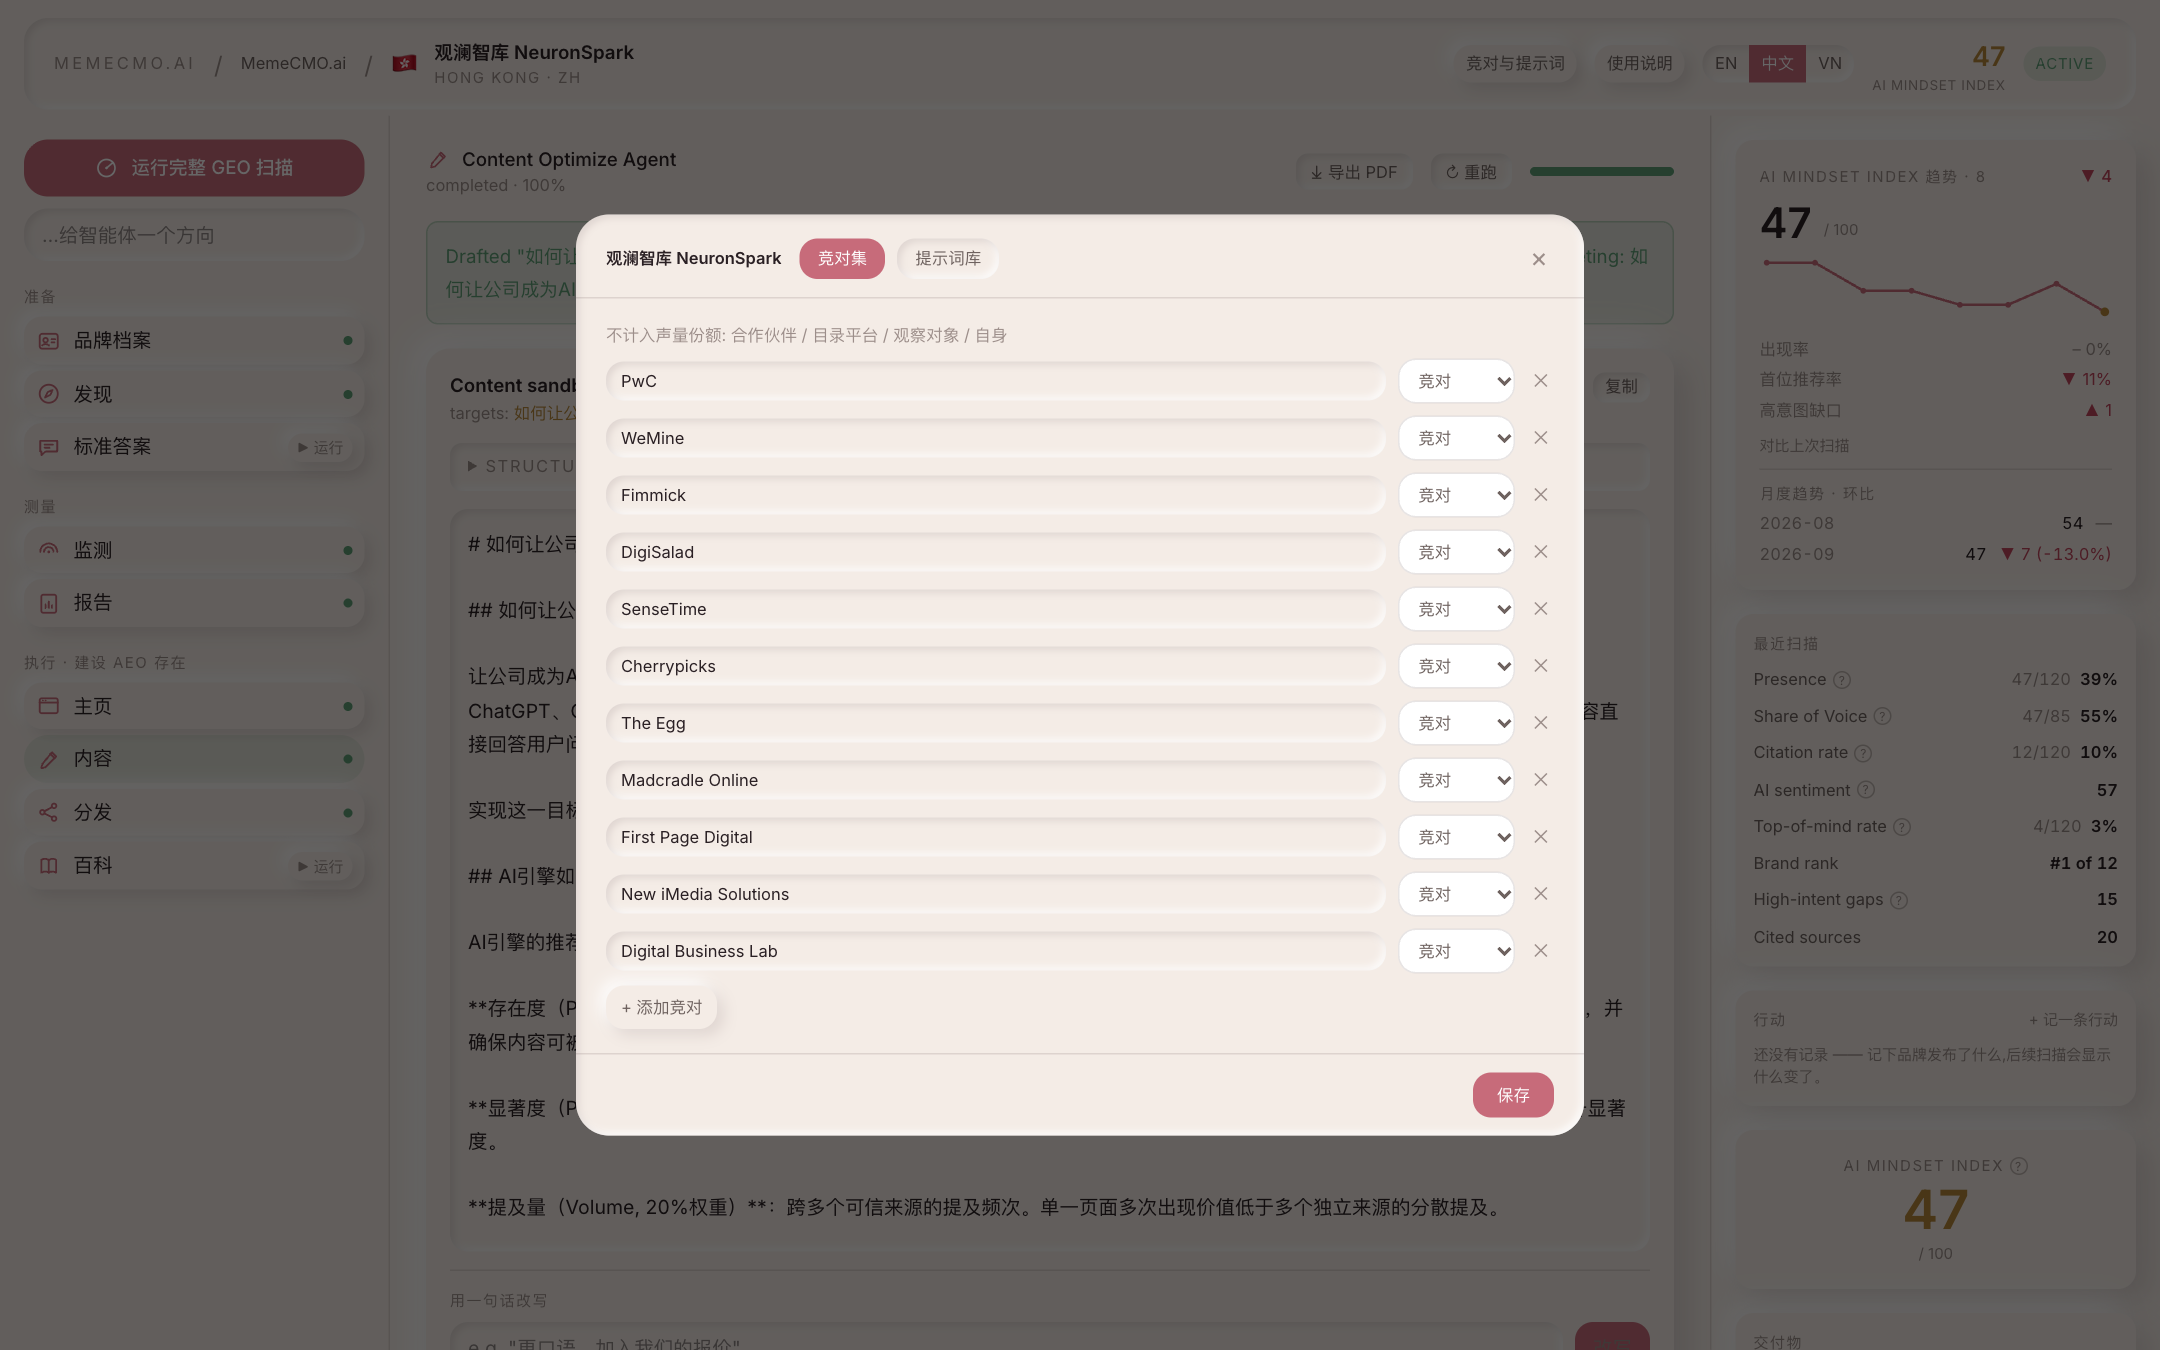
工作区页头「竞对与提示词」,项目成员可用。所有修改存于项目配置;发现阶段的原始资产与历史扫描永不改动,可随时恢复。
给每个实体标关系:竞对 / 合作伙伴 / 目录平台 / 观察对象 / 自身——只有「竞对」进声量份额、基准与缺口计算,「观察对象」只画线不进分母。标记跨月度刷新自动继承:标过合作伙伴的实体不会再被识别成竞对。也可改名、删除、手动添加。
点击任意提示词排除 / 恢复(划线显示);点 ✎ 把一条题改写成更地道的本地问法,并写下「为什么这样改」——改写与理由都进入编辑日志,沉淀为训练数据。底部可逐行新增自定义提示词并归组。修改自下次扫描起生效。
合同里的 Core 题目标为「已冻结」:界面不允许改动,修改需双方书面确认后由运营方执行。这是为了让逐期数据可比。
AI 从真实回答提取竞对,但「谁算竞对」是商业判断——机器负责发现,人负责定性。每一次你的定性都被记录、被复用,这是你在系统里沉淀的资产。
语言:提示词 / 交付物 / 界面
提示词语言 = 买家真的用什么语言问 AI(越南 = 越南语,香港 = 繁體中文 + 粵語口語,美国 = 英语);交付物语言 = 报告、内容稿写给谁看(默认跟市场,可按项目改);界面语言 = 你操作平台的语言(中 / EN / VN),只影响按钮和标题。
建项目时选市场即确定前两者;运营方可在项目设置里改交付物语言(如客户要求中文报告)。改动只影响之后的运行,历史交付物不变。
交付物保持市场语言不变;点页头「中文 / EN」在页内翻译阅读,原始资产不动。翻译只在交付物语言与阅读语言不同时出现。
越南语、泰语等非英语输出更长,平台按语言给模型更大的输出预算与更长的超时;被截断的输出不会被当作成功保存,会自动重跑。
AIGVR 五维算法
每次监测把 Prompt 库抽样后同题发给 5 个 AI 引擎,回答由评委模型(温度 0.1)逐条结构化打分,再聚合为五个维度(各 0–100)与一个综合分。界面展示名为「AI Mindset Index」(合同指标名为 AIGVR 的客户仍显示 AIGVR),算法相同。评分卡头部呈现六个互不重叠的指标:出现率 / 声量份额 / 出现时位置(首位推荐率为其重点过滤视图)/ 出现时情感 / 引用强度 / 高意图缺口数。
20 条重点 Prompt 每次全测,其余按阶段均衡抽样至套餐上限(每次 12 / 20 / 24 条);× 引擎数 ≈ 48–120 次真实查询。问题按意图二分呈现:高意图(谁提供 / 最好 / 价格 / 比较 / 品牌名 / 地点等购买信号)与教育型——教育型里 AI 很少点名品牌,出现率低属正常,这些问题输出为内容选题。缺口清单只统计高意图问题。为保证分数可比:prompt 库与竞品名单均冻结复用、每月刷新。置信标注:单元格 n≥12 高 · ≥6 中 · <6 低。
提及品牌的回答 ÷ 全部有效回答。
被提及时的位置得分均值:0 未提 · 1 顺带 · 2 多选之一 · 3 首选 / 重点推荐;按 ÷3×100 归一。
品牌提及次数 ÷(品牌提及 + 竞品提及)。竞品从真实回答里提取,且只计关系标签为「竞对」的实体;评分卡会注明哪些实体被排除及原因。
被提及时的态度均值:正面 1 · 中性 0.5 · 负面 0。
回答中引用品牌自有域名链接的比例(AEO 信号,Perplexity 与 Google AIO 贡献最多)。标准 v1.1 §3.6 要求引用覆盖至少 4/5 引擎才报告该指标。
AIGVR = 0.30·Presence + 0.25·Prominence + 0.20·CompetitiveShare + 0.15·Sentiment + 0.10·Citation不数关键词——评委模型读完整回答后输出结构化判定(是否提及 / 位置 / 情感 / 竞品名单),温度 0.1、批量送审;竞品名单由第二个抽取器从回答文本中提取(温度 0.2),避免「猜竞品」带来的假阳性。每条判定的原答都能在看板里点开复核;人工纠正的标签永远不会被机器覆盖。
首位推荐率与重点 Prompt
首位推荐率(合同 KPI)= 品牌作为首选 / 重点推荐(prominence = 3)的回答 ÷ 全部查询。评分卡同时给出整体值与 20 条重点 Prompt 的子集值(keySet 独立成线,n = 20 × 引擎数)。
真实界面 vs API 代理
五个引擎里,Google AI Overview 是「真实界面」——抓取真实 Google 搜索结果页(按市场本地化 gl/hl,越南 = vn/vi),用户真实看到什么就测什么;其余四个(ChatGPT / Gemini / Perplexity / Claude)走模型 API,是「API 代理」——同模型但非消费者界面,界面上有明确标注。某条查询 AIO 超时即记为「该题无 AIO」,不影响其他引擎;某引擎连续不可用会在报告注明并只按其余引擎计算。
Day-0 基线、趋势与定期扫描
项目的第一次监测自动成为 Day-0 基线,右栏趋势线展示 AIGVR / 可见度 / 缺口随每次扫描的变化。趋势图下方是「月度趋势 · 环比」:每个自然月取最后一次扫描为月度快照,跨月后自动生成。定期扫描按套餐节奏由平台自动执行(Starter 每月、Growth 每两周、Scale 每周,扫描日可按客户管理节奏设定),定期扫描不扣 credit。注意:引擎组合或竞对口径变化会打断严格可比性——趋势解读以同口径区间为准,口径变更处会注明。
行动记录与自动核验
右栏「记录一个行动」或交付物上的「标记为已发布」:填 URL、类型(官网更新 / 文章 / 目录 / 百科 …)、发布日期与针对的问题。发布日期不能是未来。
平台随后抓取该 URL:是否可达、标题、词数、内容哈希;之后每周重抓,内容变化会记下「变更时间」。记录上显示「✓ 已上线 · N 词」或「✗ 不可达」。
每次新扫描后,系统按「发布日期之前 vs 之后」比较针对问题的出现率(逐引擎),以及该域名被引用次数的前后变化;写进周报的「行动与变化」段落。
这是把你的执行沉淀成系统资产的地方:哪类行动在哪个引擎上有效,只有记录下来才能被下一次计划复用。三个月以上的项目,这条记录就是最有价值的数据。
结果操作:沙箱 / 顾问 / 翻译 / 导出
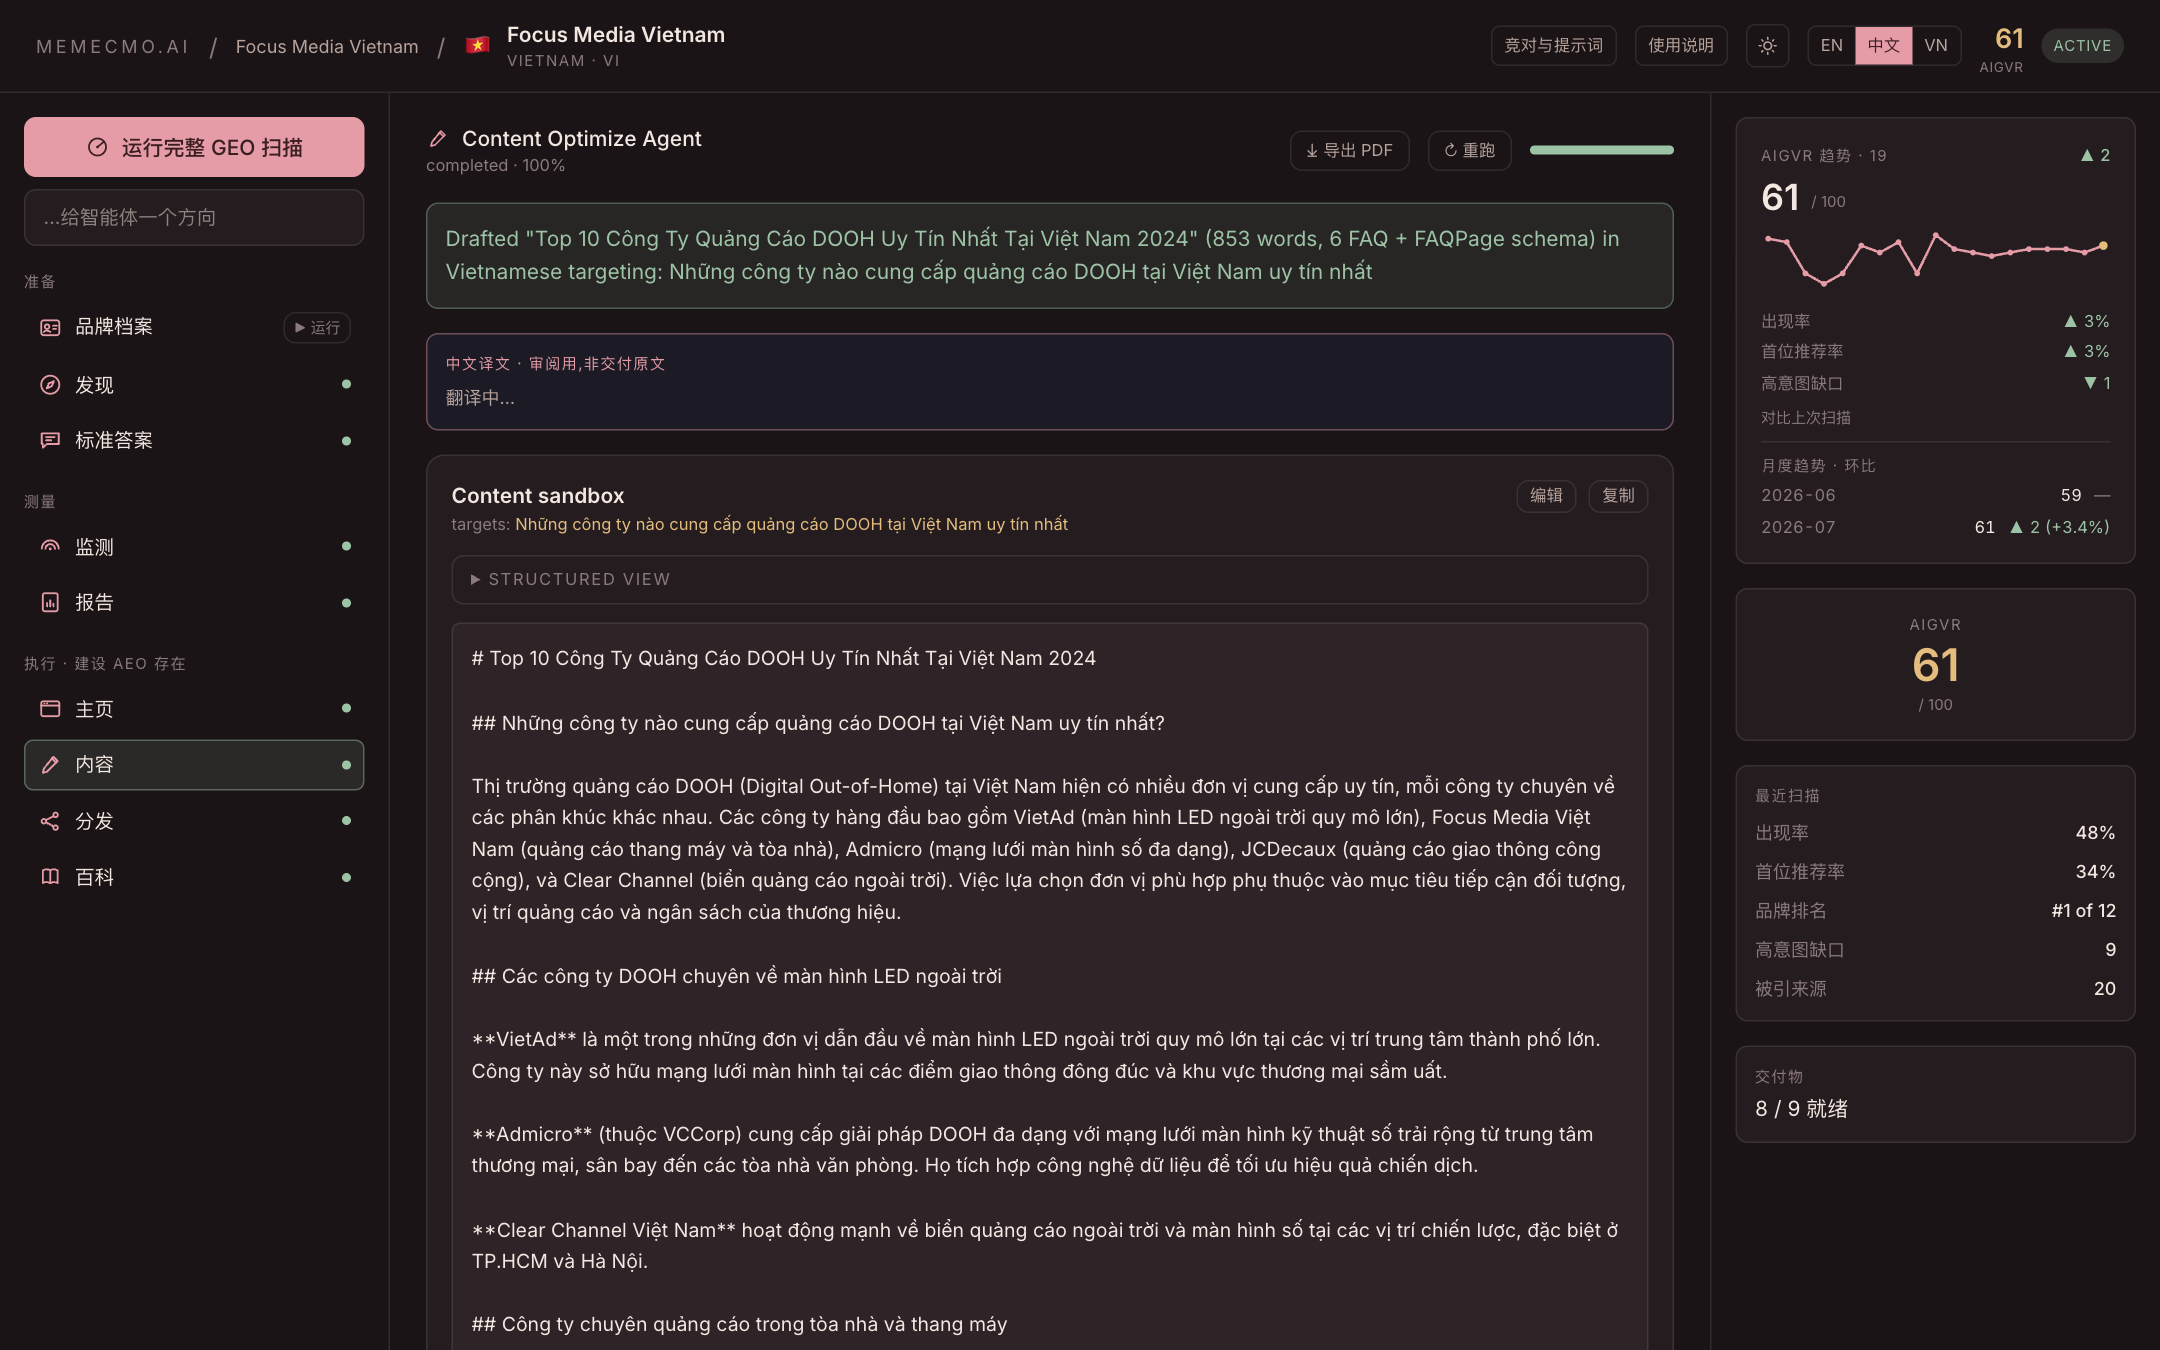
每个创作型交付物是可编辑工作副本:直接改文本、按快捷指令或一句话让 AI 修订,版本栈可回退,复制即用。修订基于当前稿,不会推倒重来。
你在任何交付物上做的编辑(标签、改写、删除)都记在编辑层,重跑时重新叠加在新结果之上——机器永远不会覆盖人的判断。
在结果下方直接提问(「哪个缺口先打?」),回答锚定当前数据,并给出下一步智能体的一键入口。
交付物保持市场语言不变,点「中文 / EN」在页内翻译阅读,原始资产不动。
舞台头部「重跑」按钮;监测类重跑 = 新的趋势数据点;手动触发按 credit 计(完整扫描 / 监测 25,其余 10),失败自动退回。
舞台头部「导出 PDF」(或 ⌘P):白底品牌页眉文档,自动展开全部折叠内容,隐藏界面元素。
合规与防编造
内容、分发、主页智能体只能使用品牌画像与你上传资料里的数字;凡是找不到出处的数字一律替换为占位符,由你填入。这是对「AI 编数据」的硬性防线。
分发目标自动排除竞对集里的域名、竞对的供应商站点,以及你在项目里标注排除的域名。
所有智能体只能生成可验证的事实信息,任何第一人称用户体验口吻(中 / 英 / 越 / 泰 / 印尼 / 马来 / 菲语全覆盖检测)一律判为伪造证言并丢弃——体验只能来自真实顾客。
越南语等输出会扫描汉越直译的生硬用语,改用市场里真实的说法;提示词库的 ✎ 改写与理由会反哺这一规则。
论坛与社群(Reddit / Quora / Facebook 群组及本地论坛)不代写帖子,输出「互动简报」:去哪些社区、别人在问什么、我们能提供哪些经过验证的事实;参与必须用披露身份的官方账号。
「行业领先」「用户数百万」类无出处宣称会被确定性扫描逐条标 ⚠,替换为品牌档案中的事实或删除后才发送。
维基类内容仅由百科智能体产出,固定附:付费关系披露 → 草稿评审或编辑请求 → 独立编辑审核合入。绝不直接发布。
顾客评价内容永不代写。报告只会建议「真实评价招揽」:给客户自己的顾客发邀请链接,评价由真实顾客撰写。
组织、邀请、配额与周报
MemeCMO(总部)→ 渠道商 → 终端客户;数据行级隔离(Postgres RLS),互相不可见。
渠道商管理员在工作台点「+ New client」→ 总部审批队列 Approve → 客户组织激活并自动获得订阅。
组织标题行「Invite」→ 填邮箱与角色 → 自动发邮件(或复制链接);对方用被邀邮箱登录即入组。admin:组织、邀请、账单;editor:可运行智能体、记录行动、编辑交付物;viewer:只读、导出 PDF、就结果提问。席位免费不限量。
每月计量扫描(完整扫描 / 监测)上限:Starter 4 · Growth 12 · Scale 30,定期扫描计入;总部与渠道商不计量。超额返回明确提示,下期重置。
组织管理员在工作台点「连接器」生成密钥,把 MemeCMO 接进 Claude、Cursor、Zapier 等环境:读取评分卡、缺口、信源与交付物,内容在你自己的渠道发布后用 log_action 登记,平台自动核验并在下次扫描归因。一把密钥只能看自己组织;平台不发布内容、不保管社媒令牌。说明见 /connector。
配置收件人后按项目的周报日(默认周二)自动发送:精简数字区(指数 / 分引擎 / 本期交付)+ 效果归因与策略建议 + 「行动与变化」;解读口径随项目阶段自动切换(建设期不解读分数波动)。完整数据始终在工作台下载 PDF。掉分 ≥5 或某引擎归零会即时告警,不等周期。
套餐、Credit 与计费
Starter US$99 · Growth US$199 · Scale US$1,999+,按「品牌 × 市场」按月订阅。套餐决定定期扫描节奏、题库上限、引擎数、项目数、报告频率与内含 credit;完整服务项与计费规则见 /pricing。
不是"若干次扫描",而是完整交付服务:冻结面板上可比的定期扫描、自动报告与告警、内容智能体、看板与席位。Starter / Growth 为自助服务;只有 Scale 含顾问会议。
"立即触发权"。定期扫描永远不耗 credit;你自己点「运行」的即时加跑才计(完整扫描 / 监测 25,其余 10)。Growth / Scale 每月赠 50 / 150;点包 250 / 1,150 / 3,900 credit 对应 US$250 / 1,000 / 3,000。
赠送池(月度内含、活动赠送)优先扣减、不开票;购买池可开票。失败的运行自动退回。运营方替你做的交付运行不扣 credit。
自助注册可获一次免费预览扫描(2 引擎 × 8 题),之后订阅;或由渠道商 / 组织邀请加入。每次扫描都是真实的引擎费用,所以没有无限免费扫描。
订阅进入 past_due / canceled 后:扫描暂停,但看板、全部历史与 PDF 导出保留——数据归客户,终止后 12 个月内可要求导出。恢复订阅即恢复扫描。
常见问题排查
舞台会显示具体原因;点「重跑」即可——执行层有断点续跑,已完成阶段不会重复计费,失败运行扣的 credit 自动退回。
正常时长 2–4 分钟;各引擎并行,单引擎慢不阻塞整体。任务在服务器运行,可离开页面。若长时间停在同一进度,重跑一次。
多为该引擎当次全部超时(如 AIO 波动),不影响其他引擎;重扫通常恢复。连续不可用会在报告注明。
当月计量扫描(完整扫描 / 监测)达套餐上限;升级套餐或等周期重置,其他智能体不受限。
手动加跑需要 credit;定期扫描与报告照常。工作台「套餐与账单」可购买点包,或等下月赠送。
交付物语言跟随项目的市场(建项目时选定),不是界面语言;要中文阅读用页头阅读语言切换;要改交付物语言请联系运营方改项目设置。
矛盾判定只对照你官网已公开的页面;若官网未更新,先更新官网,再记录一个行动,下次扫描会重新比对。
邀请与被邀邮箱绑定且 14 天有效;确认对方用该邮箱登录,过期就重发一条。